Melakukan optimasi model AI lokal kini menjadi benteng pertahanan krusial bagi korporasi yang ingin memanfaatkan kecerdasan buatan tanpa mengorbankan privasi data berharga. Tergiur oleh janji efisiensi model bahasa besar berskala masif, banyak organisasi terburu-buru menyalurkan dokumen internal sensitif ke antarmuka pemrograman aplikasi milik penyedia komersial pihak ketiga. Keputusan tergesa-gesa tersebut kerap memicu kecemasan mendalam seputar kebocoran rahasia dagang, sengketa kepatuhan regulasi privasi, hingga lonjakan biaya sewa komputasi awan yang tak terkendali. Menjalankan model secara mandiri di dalam ekosistem peladen privat memberikan kendali penuh terhadap aset digital, namun langkah ini sering kali terganjal oleh keterbatasan kapasitas memori perangkat keras.
Kecerdasan buatan yang berjalan di lingkungan tertutup menuntut perlakuan arsitektural yang sangat spesifik agar tidak membebani infrastruktur komputasi internal. Tanpa penyesuaian yang tepat, pengoperasian model berskala puluhan miliar parameter akan menghabiskan memori akses acak video dalam hitungan detik, melumpuhkan peladen, dan menghasilkan waktu latensi yang tidak dapat ditoleransi oleh operasional harian. Tantangan nyata yang dihadapi para profesional teknologi informasi bukan lagi sekadar mengunduh berkas model sumber terbuka, melainkan bagaimana merekayasa alur kerja komputasi agar setiap token yang diproses berjalan gesit dengan sumber daya perangkat keras minimal.
Urgensi Kedaulatan Data dan Batasan Komputasi Infrastruktur Mandiri
Membangun fasilitas komputasi kognitif di balik tembok api perusahaan merupakan pilihan strategis untuk mengamankan kekayaan intelektual. Kendati demikian, banyak tim teknologi informasi terbentur pada kesenjangan ekspektasi antara kecepatan peladen awan industri raksasa dan keterbatasan kluster peladen lokal. Pemahaman mendalam mengenai batas kemampuan perangkat keras mutlak diperlukan sebelum merancang arsitektur perangkat lunak yang menopangnya. Sesuai dengan standar verifikasi fakta redaksi kami, stabilitas sistem digital perusahaan harus diukur dari ketahanan jangka panjang dan efisiensi konsumsi daya, bukan semata-mata angka parameter di atas kertas.
Pergeseran Paradigma dari Komputasi Awan ke Sistem Internal
Ketergantungan buta pada platform kecerdasan buatan berbasis awan memunculkan kerentanan baru berupa hilangnya kedaulatan atas rekaman transaksi bisnis. Ketika model memproses dokumen kontrak, data penggajian karyawan, atau formula riset internal, data tersebut berpotensi tersimpan pada peladen pihak luar yang berada di luar yurisdiksi perlindungan data domestik. Mengalihkan beban kerja ke infrastruktur komputasi mandiri memastikan alur komunikasi data tidak pernah melintasi batas jaringan perimeter perusahaan, sekaligus memangkas pengeluaran biaya operasional berulang.
Ancaman Nyata Pembajakan Data Melalui Jalur Pihak Ketiga
Ancaman peretasan melalui rantai pasok perangkat lunak kian berkembang menjadi momok menakutkan bagi industri perbankan dan kesehatan. Berdasarkan arahan resmi mengenai ketahanan infrastruktur informasi penting yang diterbitkan dalam pedoman keamanan siber BSSN, proteksi data digital strategis menuntut kontrol penuh atas setiap simpul komputasi yang memproses data sensitif. Membiarkan saluran API luar berinteraksi langsung dengan pangkalan data internal memperluas bidang serangan yang dapat dimanfaatkan oleh aktor jahat untuk melancarkan penyadapan data.
Strategi Reduksi Bobot Model Tanpa Mengorbankan Akurasi Penalaran
Menjejalkan model bahasa besar ke dalam kartu grafis kelas korporasi tanpa persiapan teknis adalah resep pasti menuju kegagalan sistem akibat kehabisan memori. Fondasi utama keberhasilan optimasi model AI lokal bertumpu pada keselarasan antara teknik representasi numerik dan ketersediaan bandwidth memori perangkat keras yang digunakan. Mengurangi ukuran berkas bobot model menjadi langkah wajib guna membebaskan ruang komputasi tanpa melucuti kemampuan logika analitis yang tertanam di dalamnya.
Teknik Kuantisasi Empat Bit untuk Menghemat Memori Grafis
Kuantisasi merupakan teknik konversi nilai bobot model dari representasi presisi tinggi 16-bit floating point menuju format yang lebih padat seperti integer 4-bit. Format modern seperti Activation-aware Weight Quantization dan GPT-Generated Unified Format terbukti mampu memangkas kebutuhan memori grafis hingga lebih dari enam puluh persen. Dengan kompresi terarah ini, model dengan parameter sebesar 14 miliar yang tadinya membutuhkan kartu grafis ganda berkapasitas masif kini dapat dieksekusi dengan lancar pada satu unit pemroses grafis berkapasitas memori standar.
Pemangkasan Bobot Selektif demi Menjaga Ketajaman Logika
Selain konversi numerik, pemangkasan parameter yang tidak krusial menjadi metode cerdas untuk menjaga kestabilan model. Melalui proses kalibrasi menggunakan dataset khusus yang menyerupai pola operasional harian perusahaan, jaringan saraf tiruan dapat dipangkas pada bagian lapisan yang jarang aktif saat inferensi berlangsung. Pendekatan selektif ini menjadikan strategi optimasi model AI lokal ini sangat hemat sumber daya, sekaligus mempertahankan skor akurasi pemahaman konteks tetap berada pada tingkat toleransi yang aman bagi operasional bisnis.
Arsitektur Inferensi Ringan untuk Mengakselerasi Throughput Token
Setelah bobot model berhasil dirampingkan, fokus rekayasa sistem beralih pada mekanisme eksekusi inferensi di dalam memori. Mesin eksekusi standar sering kali membuang-buang sumber daya komputasi karena tidak dirancang untuk menangani konkurensi permintaan pengguna secara optimal. Penggunaan kerangka kerja inferensi mutakhir yang dirancang khusus untuk throughput tinggi menjadi pembeda nyata antara sistem yang tersendat-sendat dan sistem yang responsif.
Optimalisasi Cache Konteks pada Skenario Dokumen Panjang
Tantangan terberat saat menjalankan model bahasa besar secara internal terletak pada ledakan konsumsi memori akibat panjangnya riwayat percakapan atau dokumen yang dianalisis. Teknologi alokasi memori dinamis seperti PagedAttention memecah memori cache nilai kunci menjadi blok-blok terfragmentasi yang terkelola rapi, meniru cara kerja memori virtual pada sistem operasi modern. Pengelolaan cerdas ini mencegah pemborosan memori grafis hingga delapan puluh persen, sehingga dalam agenda optimasi model AI lokal berkecepatan tinggi, sistem tetap sanggup memproses buku panduan teknis yang tebal tanpa mengalami penurunan kecepatan generasi kata.
Pemanfaatan Mesin Eksekusi Khusus Berbasis Kernel Terakselerasi
Mengganti pustaka bawaan dengan mesin inferensi khusus seperti vLLM atau TensorRT-LLM membuka potensi penuh akselerasi komputasi berbasis silikon. Mesin-mesin ini memanfaatkan kernel komputasi tingkat rendah yang menyatukan operasi perkalian matriks dan atensi menjadi satu siklus instruksi terpadu. Hasilnya adalah penurunan latensi waktu menuju token pertama secara drastis, sehingga alur kerja optimasi model AI lokal dapat melayani puluhan permintaan staf operasional secara serempak tanpa menimbulkan antrean pemrosesan yang melelahkan.
Integrasi Lapisan Keamanan Berlapis pada Saluran Masukan Perintah
Membawa model kecerdasan buatan ke jaringan lokal bukan berarti sistem sepenuhnya kebal dari upaya manipulasi. Serangan siber modern kini memanfaatkan rekayasa perintah canggih untuk mengelabui pembatas sistem dan memaksa model membocorkan data rahasia yang tersimpan dalam riwayat sesi. Mengamankan gerbang masukan perintah menjadi keharusan mutlak sebelum layanan kecerdasan buatan dibuka untuk konsumsi seluruh divisi perusahaan.
Penyaringan Masukan untuk Menghalau Serangan Siber Tak Terlihat
Penyusupan instruksi tersembunyi yang disematkan dalam berkas digital, surel bisnis, atau teks tak terstruktur dapat memicu perilaku model yang menyimpang dari protokol keamanan internal. Membangun pagar pengaman semantik di depan model utama bertindak layaknya sistem pencegah intrusi pada jaringan komputer. Modul pemfilteran ringan bertugas memeriksa setiap masukan pengguna, membersihkan karakter mencurigakan, serta membatalkan proses eksekusi seketika jika terdeteksi indikasi manipulasi instruksi sistem dasar.
Validasi Keluaran Otomatis demi Menangkal Halusinasi Sistem
Langkah proteksi tidak boleh berhenti pada gerbang masukan teks, melainkan harus mencakup pengawasan terhadap teks yang diproduksi oleh model. Filter keluaran bertugas memindai respons sistem terhadap potensi kemunculan nomor identitas kependudukan, nomor rekening bank, maupun frasa kata sandi yang mungkin terbawa secara tidak sengaja dari korpus pangkalan data pengetahuan. Kematangan tata kelola keamanan masukan membuktikan bahwa optimasi model AI lokal bukan sekadar persoalan teknis inferensi, melainkan bagian integral dari strategi pertahanan siber korporasi.
Langkah Taktis Membangun Ekosistem Kecerdasan Buatan yang Berkelanjutan
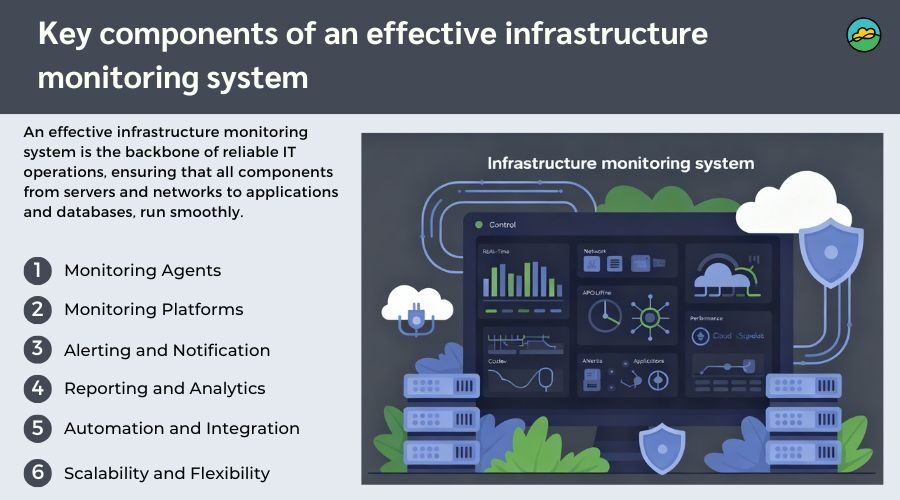
Penguasaan teknologi kecerdasan buatan secara mandiri adalah maraton teknologi yang menuntut disiplin evaluasi berkelanjutan. Pemantauan metrik operasional seperti pemanfaatan memori grafis, kecepatan pembentukan token per detik, dan suhu operasional peladen harus tercatat dalam sistem telemetri terpusat. Ketika beban kerja operasional meningkat seiring waktu, pembaruan model dapat dilakukan melalui adaptasi berbobot rendah menggunakan metode penyesuaian parameter mikro tanpa perlu melatih ulang model dari awal.
Mengintegrasikan sistem pengambilan data terarah pada pangkalan data internal melengkapi kapabilitas model lokal tanpa perlu memperbesar ukuran parameter dasar. Melalui serangkaian tahapan rekayasa teknis yang disiplin, eksekusi optimasi model AI lokal sukses menghadirkan lingkungan kerja cerdas yang berdaulat, berkinerja tinggi, dan berdaya tahan kuat terhadap ancaman kebocoran data masa depan.