Menguasai cara menjalankan AI lokal secara mandiri kini menjadi keahlian krusial bagi siapa saja yang ingin menjaga kedaulatan informasi digital mereka. Selama beberapa tahun terakhir, ketergantungan publik pada platform kecerdasan buatan berbasis komputasi awan menciptakan ilusi bahwa pemrosesan bahasa alami berkinerja tinggi hanya bisa dicapai melalui peladen raksasa milik korporasi multinasional. Kenyataannya, setiap perintah, dokumen rahasia, maupun baris kode pemrograman yang dikirimkan ke peladen eksternal berpotensi dianalisis kembali untuk pelatihan model generasi berikutnya. Kondisi ini memicu kekhawatiran nyata di kalangan profesional teknologi, pegiat privasi, hingga institusi finansial yang terikat aturan kerahasiaan ketat.
Perkembangan pesat ekosistem sumber terbuka telah membalikkan paradigma tersebut secara drastis. Saat ini, model bahasa berskala miliaran parameter dapat dipadatkan sedemikian rupa sehingga mampu dieksekusi secara mulus pada perangkat keras konsumen biasa tanpa memerlukan koneksi internet sama sekali. Mengambil kendali atas infrastruktur komputasi sendiri bukan sekadar hobi teknis kaum antusias, melainkan benteng pertahanan paling kokoh dalam melindungi kekayaan intelektual serta kerahasiaan pribadi.
Alasan Krusial Mengapa Model Bahasa Mandiri Menjadi Kebutuhan Utama
Layanan komputasi awan memang menawarkan kemudahan instan, namun kelemahannya mulai terasa ketika organisasi atau individu berhadapan dengan regulasi kepatuhan data. Memahami fondasi cara menjalankan AI lokal memberikan kebebasan mutlak dari sensor sepihak, fluktuasi latensi jaringan, serta risiko pemadaman layanan tak terduga.
Kedaulatan Data dan Privasi Informasi Rahasia
Ketika Anda memuat laporan keuangan, rekam medis keluarga, atau dokumen hukum internal ke dalam kotak obrolan berbasis langganan publik, Anda pada dasarnya menyerahkan kepemilikan privasi kepada pihak ketiga. Meskipun perusahaan penyedia mengklaim telah menerapkan enkripsi tingkat tinggi, riwayat pelanggaran data global menunjukkan bahwa kebocoran tetap bisa terjadi melalui kerentanan sistem autentikasi atau kelalaian internal. Dengan memproses seluruh data di dalam ruang penyimpanan lokal, lalu lintas bit data tidak pernah meninggalkan gerbang jaringan lokal rumah atau kantor Anda. Badan resmi seperti Badan Siber dan Sandi Negara senantiasa mengingatkan pentingnya ketahanan siber mandiri demi menekan ancaman eksfiltrasi informasi berharga.
Efisiensi Biaya Operasional Tanpa Langganan Berulang
Model bisnis berbasis token atau biaya langganan bulanan per pengguna kerap menjadi beban finansial tersembunyi yang membengkak seiring meningkatnya intensitas penggunaan. Tim pengembang perangkat lunak atau analis data yang melakukan ribuan kueri otomatis harian bisa menghabiskan jutaan rupiah setiap bulan hanya untuk membayar antarmuka pemrograman aplikasi pihak ketiga. Investasi pada perangkat keras yang tepat memungkinkan proses inferensi tanpa batas tanpa perlu khawatir melihat lonjakan tagihan kartu kredit pada akhir periode penagihan.
Kebutuhan Perangkat Keras Minimum untuk Komputasi Mandiri
Menjalankan kecerdasan buatan secara luring tidak selalu menuntut komputer super bernilai ratusan juta rupiah. Pemahaman mengenai spesifikasi teknis yang relevan akan menyelamatkan anggaran Anda dari pemborosan suku cadang yang sebenarnya tidak berdampak langsung pada performa pemrosesan model bahasa.
Peran Vital Kapasitas VRAM Kartu Grafis
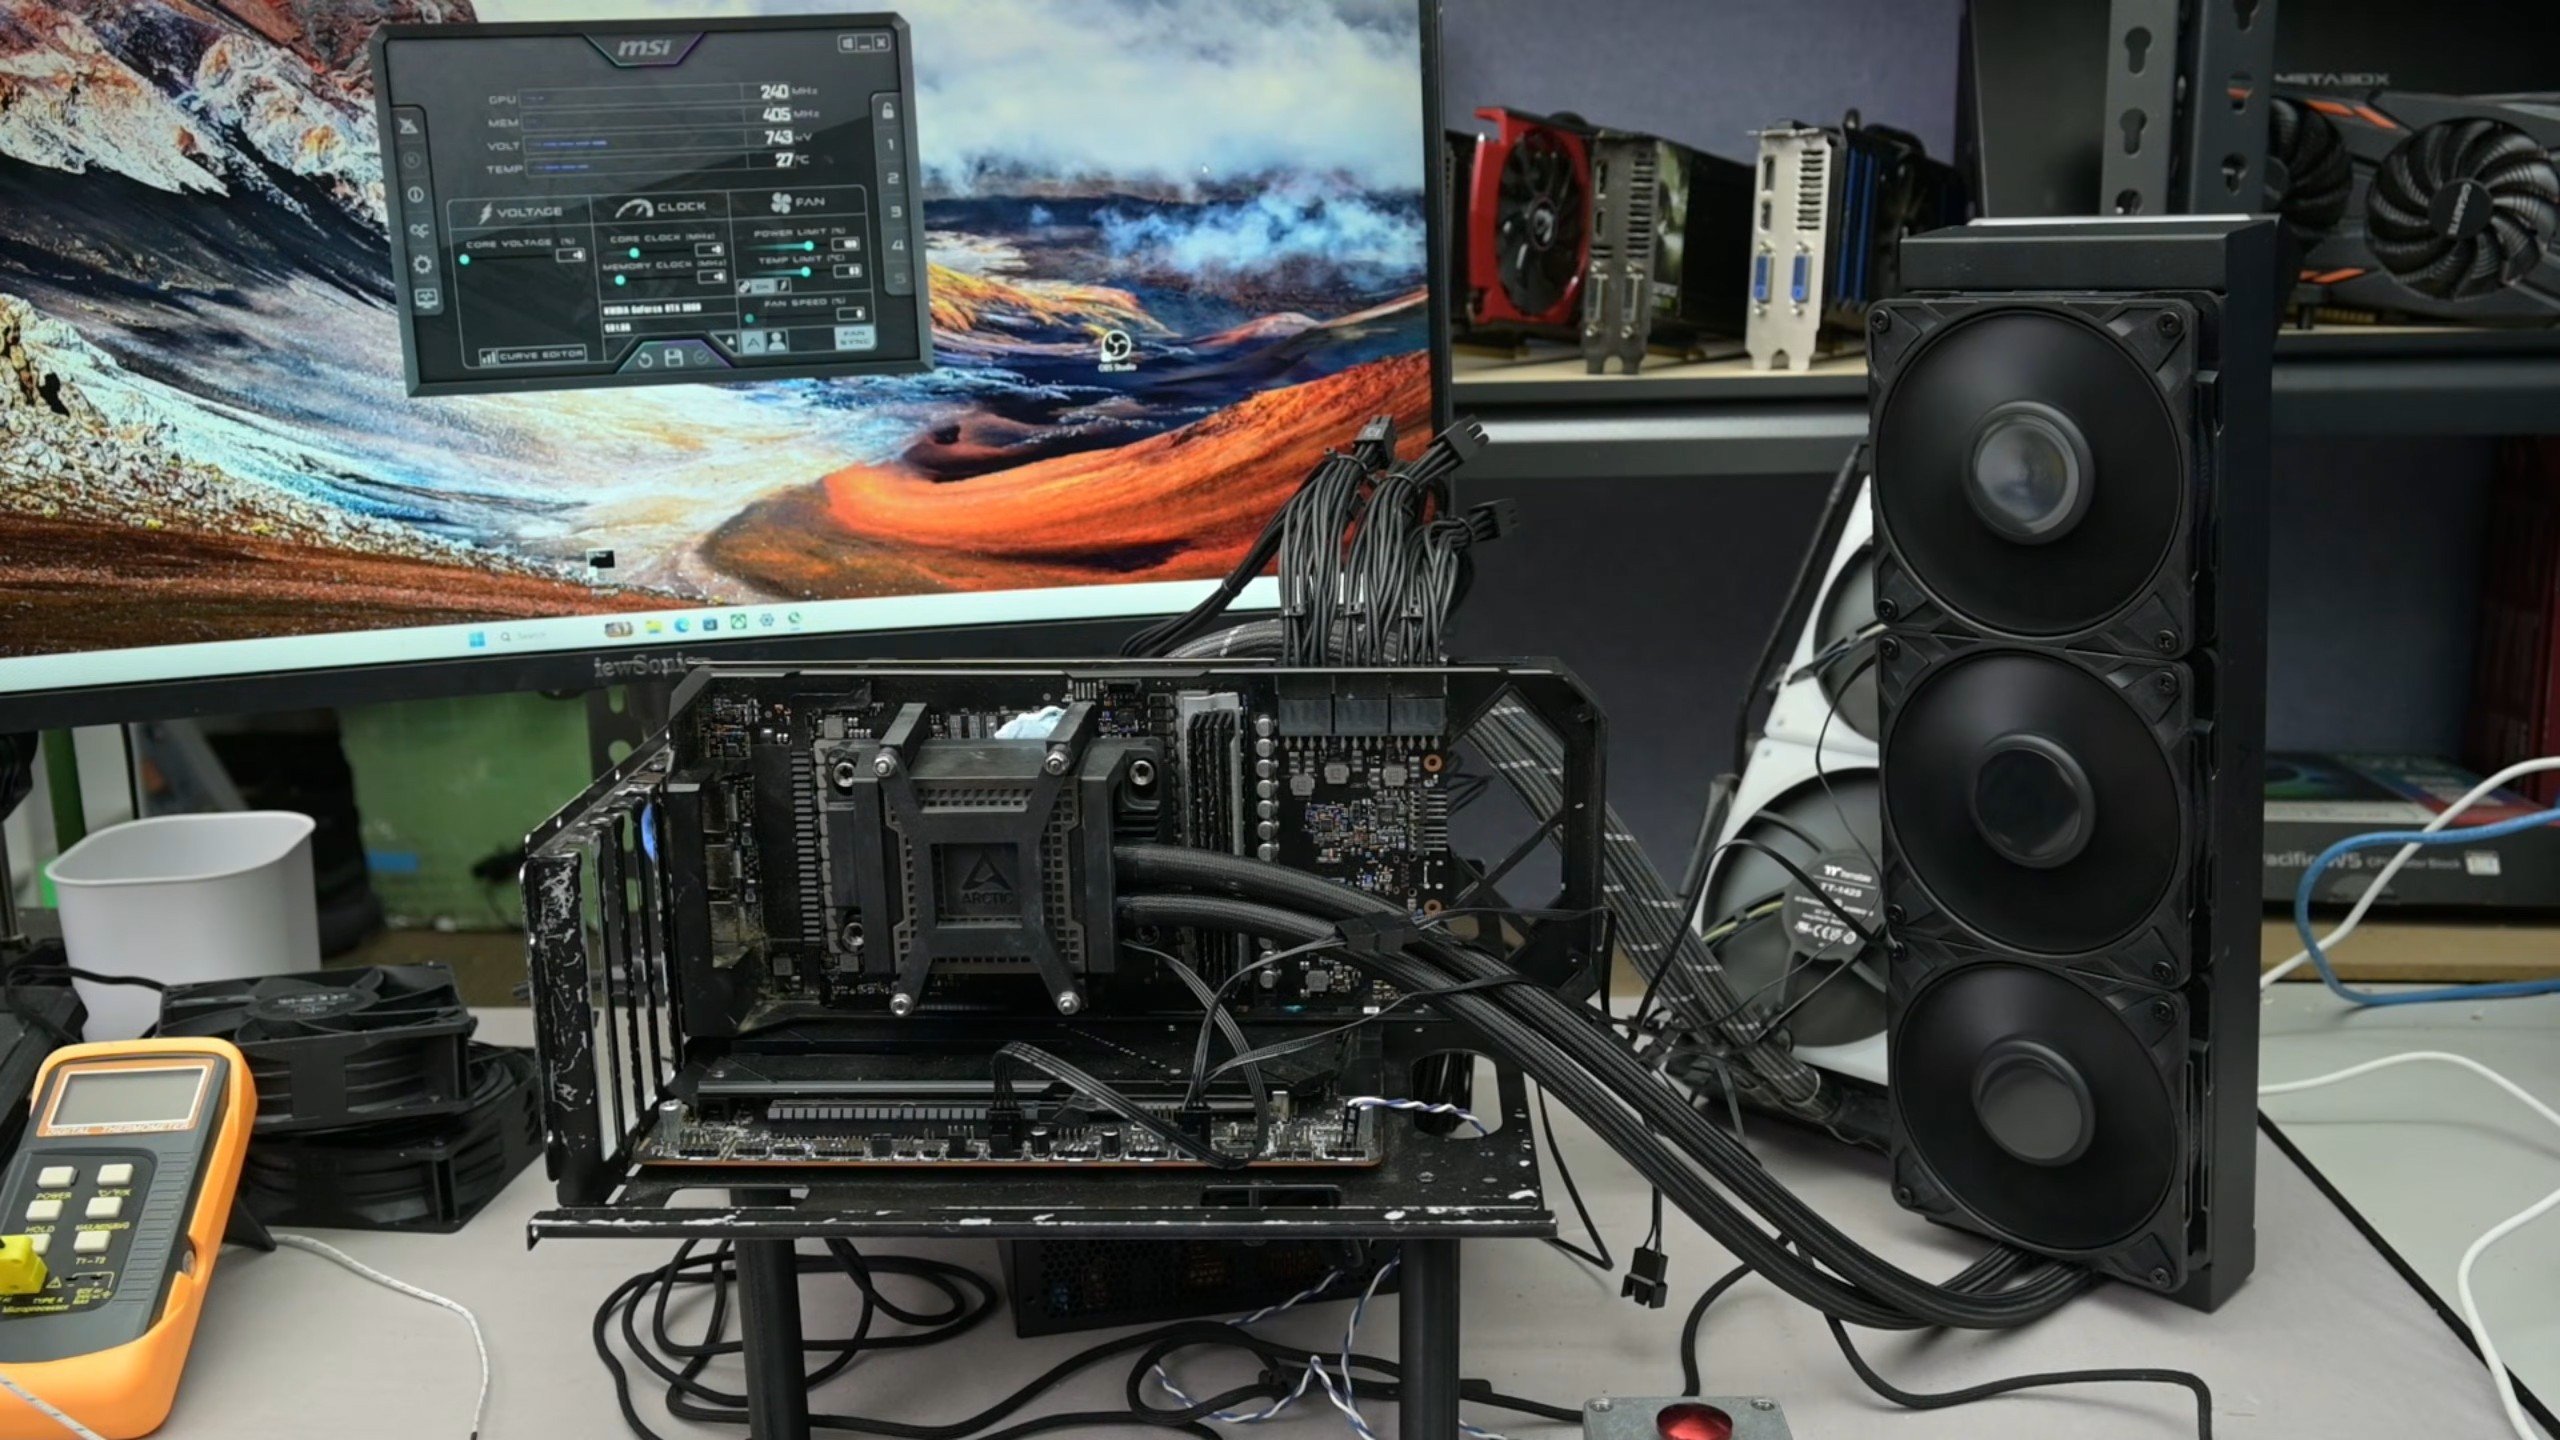
Komponen paling krusial dalam komputasi inferensi model bahasa adalah memori video atau VRAM pada kartu grafis. Model bahasa bekerja dengan memuat seluruh matriks pembobotan matematika ke dalam memori berkecepatan tinggi agar pemrosesan token kata berlangsung instan. Sebagai patokan praktis, model berukuran 7 miliar atau 8 miliar parameter dengan kuantisasi 4-bit membutuhkan setidaknya 6 hingga 8 gigabita VRAM khusus agar dapat berjalan lancar pada kecepatan belasan token per detik. Jika kartu grafis kehabisan ruang VRAM, sistem secara otomatis melimpahkan beban kerja ke memori sistem utama, yang berakibat pada anjloknya kecepatan respons secara signifikan.
Kebutuhan Memori Utama dan Kecepatan Media Penyimpanan
Bagi pengguna yang belum memiliki kartu grafis diskret bertenaga tinggi, arsitektur komputasi modern seperti prosesor seri Apple Silicon dengan memori terpadu menyajikan alternatif yang luar biasa efisien. Dalam skenario komputer berbasis prosesor konvensional tanpa kartu grafis canggih, ketersediaan RAM sistem sebesar 16 hingga 32 gigabita dengan frekuensi tinggi menjadi syarat mutlak. Selain itu, penggunaan media penyimpanan berbasis NVMe PCIe generasi terbaru sangat menentukan kecepatan waktu pemuatan awal model berukuran raksasa ke dalam memori kerja sistem sebelum sesi dialog interaktif dimulai.
Langkah Taktis Memulai Ekosistem Kecerdasan Buatan Tanpa Koneksi Internet
Transformasi dari sekadar konsumen pasif menjadi operator mandiri kini dapat dilakukan melalui antarmuka modern yang ramah pengguna. Anda tidak lagi dituntut mengompilasi kode sumber berbahasa C++ yang rumit secara manual dari baris terminal.
Pemilihan Framework Ringan Seperti Ollama dan LM Studio
Tahap awal yang paling direkomendasikan dalam cara menjalankan AI lokal adalah memasang perangkat lunak orkestrasi seperti Ollama atau LM Studio. Ollama berfungsi layaknya manajer kontainer Docker yang mengabstraksi seluruh kerumitan instalasi dependensi komputasi di balik layar. Anda cukup memasang paket aplikasi resmi pada sistem operasi Windows, macOS, atau Linux, kemudian memanggil perintah sederhana untuk mengunduh serta mengeksekusi model yang diinginkan secara otomatis. Sementara itu, LM Studio menyajikan antarmuka grafis yang sangat intuitif, lengkap dengan deteksi otomatis kecocokan perangkat keras, kurva pemantauan suhu, dan opsi penataan memori visual.
Penentuan Model Terbuka yang Tepat Sesuai Kebutuhan Nyata
Keluarga model bahasa terbuka berkembang dengan kecepatan mencengangkan. Untuk kebutuhan penalaran logika matematika, pemecahan masalah algoritma, dan penulisan teks analitis, varian model mutakhir seperti Llama 3 keluaran Meta, seri Mistral, keluarga Qwen buatan Alibaba, maupun DeepSeek menyajikan rasio performa luar biasa terhadap konsumsi memori. Memilih model dengan skala parameter 7B hingga 14B merupakan titik ekuilibrium terbaik untuk komputer meja kelas menengah, menghadirkan daya nalar setara layanan berbayar tanpa menyiksa sistem pendingin perangkat keras Anda.
Konfigurasi Kuantisasi GGUF demi Menghemat Sumber Daya Komputer
Teknik kuantisasi menjadi rahasia penting dalam efektivitas cara menjalankan AI lokal tanpa kehilangan akurasi bernalar secara drastis. Format berkas GGUF mengompres bobot model asli yang mulanya berpresisi 16-bit menjadi representasi 4-bit atau 5-bit tanpa merusak konteks pemahaman bahasa. Kuantisasi tipe Q4_K_M atau Q5_K_M umumnya menjadi rekomendasi baku komunitas global karena mampu memangkas ukuran berkas hingga lebih dari setengahnya sekaligus mempertahankan lebih dari 95 persen kapabilitas logika aslinya.
Pemasangan Antarmuka Web Interaktif Mirip Layanan Komersial
Mengetikkan teks melalui jendela terminal hitam-putih tentu terasa melelahkan bagi alur kerja harian. Memadukan Ollama dengan antarmuka berbasis web seperti Open-WebUI memungkinkan Anda menikmati pengalaman visual yang setara dengan platform komersial populer. Pengguna mendapatkan fitur riwayat percakapan bercabang, dukungan pengunggahan berkas dokumen untuk pencarian dokumen berkonsep Retrieval-Augmented Generation, hingga pengaturan kepribadian sistem yang dapat disesuaikan untuk kebutuhan analisis spesifik.
Strategi Optimasi Performa dan Integrasi Alur Kerja Harian
Memiliki model yang berjalan di latar belakang hanyalah separuh dari perjalanan teknis. Mengintegrasikan teknologi ini ke dalam rutinitas kerja harian secara mulus merupakan kunci sesungguhnya untuk mendongkrak produktivitas.
Penyesuaian Parameter Konteks dan Suhu Komputasi
Parameter operasional model menentukan seberapa kreatif atau kaku jawaban yang dihasilkan. Nilai suhu komputasi mendekati angka 0,2 sangat ideal untuk tugas-tugas ekstraksi data faktual, ringkasan riset, dan pemrograman kode karena menghasilkan respons deterministik yang konsisten. Sebaliknya, menaikkan suhu ke kisaran 0,7 hingga 0,8 memberikan ruang bagi kecerdasan buatan untuk merangkai narasi kreatif atau bertukar pikiran mengenai ide-ide konseptual yang inovatif. Memperluas jendela konteks memori kerja juga memerlukan perhitungan cermat karena semakin panjang teks yang diingat dalam satu sesi, semakin besar porsi memori VRAM yang terkunci secara permanen.
Menjaga Kebugaran Fisik Saat Berjam-jam Menatap Layar Monitor
Eksplorasi teknis yang intensif, mulai dari mengatur parameter konfigurasi hingga menguji ratusan skenario percakapan mesin, kerap membuat praktisi teknologi duduk terpaku di depan meja kerja selama berjam-jam tanpa disadari. Beban kognitif yang tinggi di depan monitor berisiko memicu penurunan daya tahan fisik jangka panjang serta atrofi otot akibat minimnya aktivitas gerak tubuh. Disiplin menyisipkan rutinitas olahraga fisik fungsional sangat diperlukan guna menjaga stamina otak tetap tajam, sebagaimana dipaparkan mendalam dalam panduan 7 Cara Latihan Kekuatan Otot Paling Efektif demi Menangkal Bahaya Sarkopenia Dini agar keseimbangan antara kebugaran raga dan produktivitas digital tetap harmonis.
Rekomendasi Mitigasi Risiko dan Pengamanan Infrastruktur Mandiri
Mengoperasikan infrastruktur komputasi sendiri menuntut tanggung jawab pemeliharaan sistem yang sebelumnya dialihkan ke pundak penyedia layanan pihak ketiga. Kelalaian kecil dalam penataan konfigurasi dapat mengakibatkan kerusakan perangkat keras atau membuka celah keamanan baru.
Mengatasi Masalah Suhu Panas Berlebih pada Komponen Mesin
Inferensi model bahasa berukuran besar memaksa prosesor grafis dan unit pengolah komputasi bekerja pada batas beban maksimum selama proses pembuatan respons berlangsung. Pastikan kurva kecepatan kipas pendingin diatur secara agresif sebelum memulai sesi pemrosesan batch dokumen panjang. Sirkulasi udara di dalam wadah komputer wajib diperiksa secara berkala untuk membersihkan akumulasi debu yang menghambat pelepasan panas, sehingga komponen terhindar dari penurunan kecepatan paksa akibat pembatasan termal sistem.
Mengamankan Jaringan Lokal dari Paparan Akses Luar Tak Dikenal
Ketika Anda memasang perangkat lunak peladen AI lokal dan mengonfigurasinya agar dapat diakses dari gawai lain dalam rumah, pastikan porta jaringan tersebut tidak terbuka ke jaringan internet publik tanpa perlindungan kata sandi yang kuat. Hindari penggunaan fitur pembelokan porta secara sembarangan pada perute internet utama Anda. Gunakan jaringan privat virtual terenkripsi seperti Tailscale atau WireGuard jika Anda benar-benar membutuhkan akses ke mesin komputasi rumah saat sedang bepergian di luar jaringan lokal.
Langkah demi langkah dalam cara menjalankan AI lokal menunjukkan bahwa kedaulatan teknologi informasi sepenuhnya berada di tangan para pengguna yang berani mengambil inisiatif mandiri. Kebebasan dari ancaman pengintaian data, tiadanya keterikatan pada biaya langganan bulanan yang melambung, serta kepastian operasional tanpa bergantung pada kestabilan internet merupakan keuntungan strategis yang tak ternilai. Dengan fondasi perangkat keras yang terukur dan penerapan konfigurasi yang tepat, ekosistem kecerdasan buatan pribadi Anda siap menjadi mitra kerja andal yang sepenuhnya aman dan berada dalam kendali penuh Anda.