Keputusan untuk menjalankan AI lokal di komputer pribadi kini menjadi solusi paling ampuh dalam menjaga kerahasiaan data sensitif tanpa ketergantungan server komputasi awan. Selama beberapa tahun terakhir, sebagian besar profesional teknologi, peneliti, dan penggiat produktivitas terjebak dalam model langganan perangkat lunak berulang. Ketergantungan ini tidak hanya menguras anggaran operasional setiap bulan, melainkan juga melahirkan kecemasan etis perihal bagaimana dokumen korporat, draf naskah paten, dan catatan analitis pribadi dikelola oleh entitas penyedia server raksasa.
Kekhawatiran tersebut bukan sekadar ilusi proteksionisme berlebihan. Rentetan insiden keamanan data global membuktikan bahwa instruksi prompt yang diunggah ke layanan daring dapat berujung pada eksfiltrasi data tanpa disengaja. Algoritma komersial kerap menggunakan masukan pengguna sebagai bahan pelatihan ulang model generasi berikutnya. Dari kebuntuan inilah lahir revolusi pemrosesan mandiri. Melalui lonjakan efisiensi arsitektur jaringan saraf sumber terbuka, komputer modern di ruang kerja Anda kini memiliki tenaga komputasi yang sanggup mengeksekusi model cerdas berkapasitas besar tanpa mengirimkan satu paket data pun keluar dari jaringan rumah.
Alasan Krusial Beralih dari Cloud Menuju Pemrosesan Mandiri
Mendelegasikan seluruh alur kerja intelektual ke pusat server asing menghadirkan ilusi kepraktisan yang dibayar mahal dengan pudarnya kontrol privasi. Ketika sebuah perusahaan atau individu tidak memiliki kendali fisik atas media penyimpanan tempat komputasi berlangsung, kedaulatan data pada dasarnya telah diserahkan sepenuhnya kepada pihak lain.
Ancaman Nyata Kebocoran Data Korporasi dan Personal
Ketika laporan keuangan kuartalan, riwayat obrolan internal, atau potongan kode sumber perangkat lunak proprietary diproses melalui peladen awan, rangkaian token teks tersebut singgah di memori server pihak ketiga. Meskipun penyedia layanan menyematkan klausa enkripsi, potensi intervensi kebijakan, celah keamanan API, atau perubahan syarat layanan secara sepihak tetap membayangi. Menurut pedoman mitigasi risiko kecerdasan buatan yang dirilis oleh National Institute of Standards and Technology, isolasi lingkungan komputasi merupakan garis pertahanan terkuat dalam mereduksi risiko eksposur informasi berharga. Memilih langkah untuk menjalankan AI lokal memberikan kendali penuh atas perimeter pertahanan digital, memastikan seluruh siklus komputasi tertahan di dalam memori fisik mesin kerja.
Kebebasan Akses Tanpa Hambatan Kuota Maupun Koneksi Internet
Pernahkah Anda mengalami kebuntuan kerja saat jaringan serat optik terputus mendadak atau saat berada di dalam penerbangan antarbenua tanpa sinyal Wi-Fi yang stabil? Ketergantungan pada komputasi awan seketika melumpuhkan produktivitas Anda. Belum lagi pembatasan laju permintaan token per menit yang diterapkan secara ketat oleh layanan komersial saat beban lalu lintas server mereka memuncak. Pemrosesan mandiri menghapus seluruh batasan artifisial tersebut. Mesin lokal Anda beroperasi layaknya aplikasi perkantoran luring konvensional, selalu siaga melayani prompt paling kompleks kapan pun dibutuhkan.
Spesifikasi Perangkat Keras yang Wajib Disiapkan Sebelum Memulai
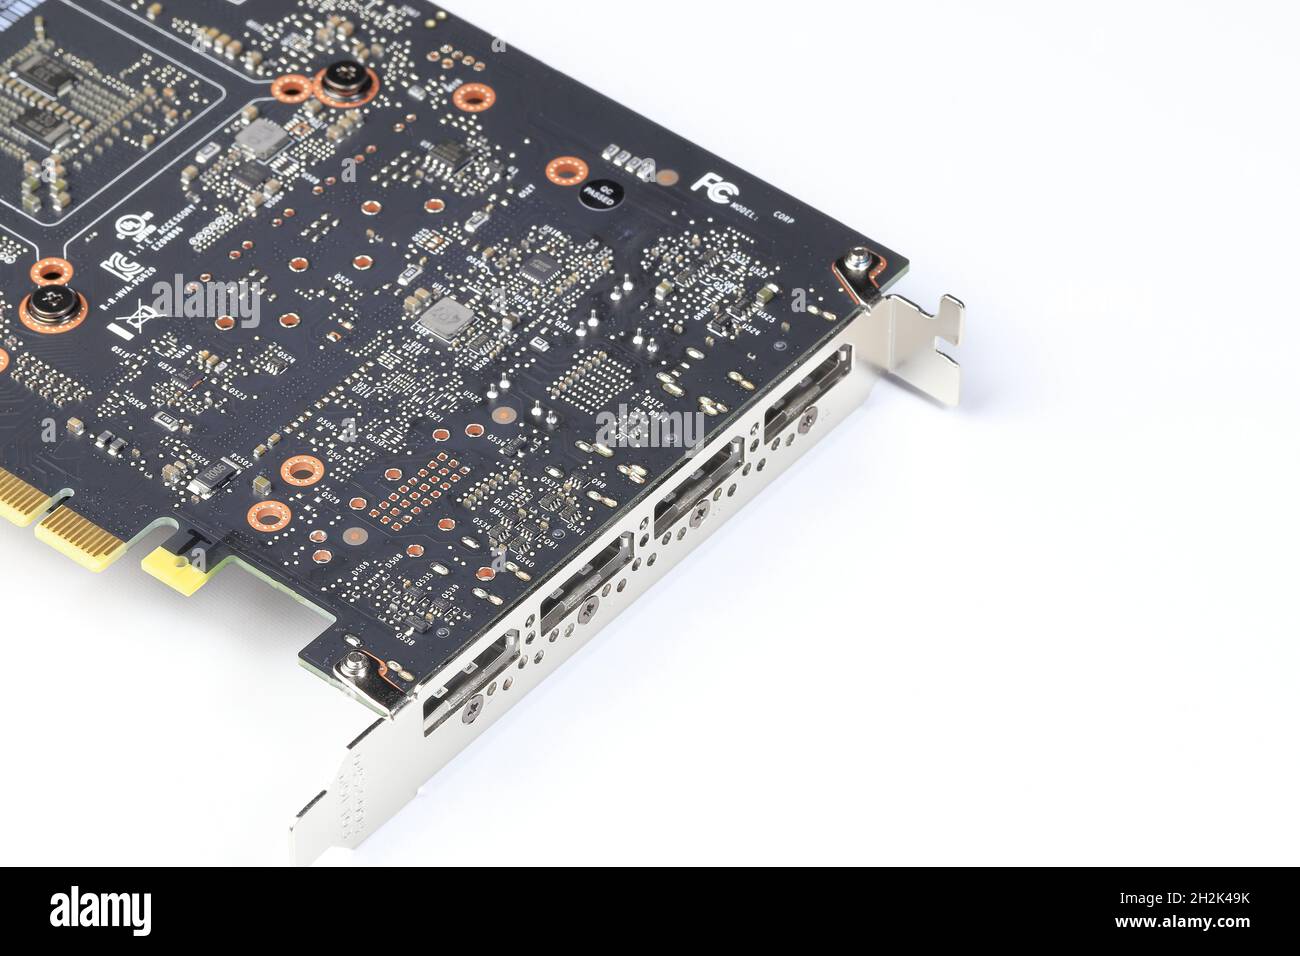
Mempersiapkan mesin kerja untuk komputasi saraf digital menuntut pemahaman mendalam mengenai arsitektur perangkat keras. Anggapan keliru yang kerap terjadi adalah menganggap prosesor komputer sebagai satu-satunya penentu performa. Pada kenyataannya, beban kerja kecerdasan buatan bertumpu pada kemampuan pemrosesan matriks paralel berskala masif. Sebelum memutuskan untuk menjalankan AI lokal di perangkat kerja harian, Anda wajib menakar keseimbangan antara kapasitas memori grafis dan kecepatan transfer data sistem.
Kapasitas Memori VRAM Kartu Grafis Sebagai Jantung Pemrosesan
Kunci utama inferensi teks tanpa hambatan terletak pada Video Random Access Memory atau VRAM yang tertanam pada kartu grafis. Seluruh bobot matematis model bahasa harus dimuat secara utuh ke dalam memori berkecepatan tinggi ini. Kartu grafis dengan VRAM 8 gigabita merupakan ambang batas minimal untuk model kompak berukuran 7 hingga 8 miliar parameter. Namun, bagi pengguna yang mengincar akurasi penalaran lebih tinggi dengan model 14 hingga 32 miliar parameter, kartu grafis dengan kapasitas VRAM 16 hingga 24 gigabita menjadi investasi mutlak agar terhindar dari pemindahan beban komputasi ke memori sistem yang jauh lebih lambat.
Peran Kecepatan Penyimpanan NVMe dan RAM Sistem
Di luar peran sentral kartu grafis, memori utama sistem berbasis DDR5 dengan kapasitas minimal 32 gigabita memegang peranan krusial sebagai penampung penyangga saat menangani jendela konteks berukuran masif. Komponen penyimpanan juga tidak boleh luput dari perhatian. File model terkuantisasi modern umumnya memiliki ukuran antara 4 hingga 20 gigabita per berkas. Menggunakan penyimpanan bertipe solid state drive NVMe generasi keempat memastikan waktu pemuatan model ke dalam VRAM berlangsung hanya dalam hitungan beberapa detik saat aplikasi pertama kali diinisialisasi.
7 Langkah Praktis Menjalankan AI Lokal Secara Mandiri
Menembus ekosistem komputasi mandiri kini tidak lagi menakutkan seperti era awal kebangkitan model sumber terbuka. Komunitas pengembang global telah merancang berbagai perkakas orkestrasi yang menyederhanakan instalasi menjadi proses beberapa klik saja. Berikut panduan teknis terstruktur dalam menjalankan AI lokal tanpa kerepotan konfigurasi baris perintah yang membingungkan.
Memilih Perangkat Lunak Eksekusi yang Ringan dan Teruji
Pondasi eksekusi bermula dari pemilihan perangkat lunak inferensi. Dua platform yang saat ini merajai komunitas berkat keandalan dan kestabilannya adalah Ollama dan LM Studio. Bagi pengguna yang menyukai kesederhanaan antarmuka visual berbasis desktop di sistem operasi Windows maupun macOS, LM Studio menyajikan fitur pencarian model langsung dari katalog global. Sementara itu, Ollama menjadi standar emas bagi pengguna yang mendambakan integrasi latar belakang yang sangat efisien dan siap dihubungkan ke beragam aplikasi produktivitas lain.
Mengunduh Model Bahasa Terbuka dengan Kuantisasi Optimal
Kualitas jawaban sangat ditentukan oleh model dasar yang Anda pilih. Pilihan terbaik yang terbukti tangguh untuk tugas analitis harian mencakup Llama 3 karya Meta, seri Mistral NeMo, serta model berdaya penalaran tinggi seperti Qwen 2.5 buatan Alibaba. Saat mengunduh, pastikan Anda memilih format GGUF dengan tingkat kuantisasi Q4_K_M atau Q5_K_M. Kuantisasi merupakan metode matematis untuk memangkas ukuran model dari presisi 16-bit menjadi 4-bit atau 5-bit, menjaga 98 persen kecerdasan model aslinya namun memangkas kebutuhan VRAM hingga lebih dari separuh.
Melakukan Konfigurasi Konteks dan Alokasi Beban GPU
Setelah berkas model terpasang, luangkan waktu untuk menyempurnakan pengaturan parameter sistem. Tentukan ukuran jendela konteks pada angka yang realistis, misalnya 8.192 token, guna menyeimbangkan daya tampung riwayat percakapan dengan konsumsi memori. Pada menu pengaturan komputasi, pastikan seluruh layer lapisan neural dialokasikan ke unit pemrosesan grafis. Pengaturan alokasi layer yang optimal akan memastikan kartu grafis menanggung seratus persen kalkulasi matriks tanpa menimbulkan pelambatan sistem akibat antrean prosesor utama.
Mengintegrasikan Antarmuka Web untuk Pengalaman Pengguna Nyaman
Bagi mereka yang terbiasa dengan kemudahan antarmuka obrolan berbasis browser, memasang Open WebUI di atas layanan Ollama adalah langkah brilian. Antarmuka sumber terbuka ini menghadirkan fitur manajemen riwayat percakapan, pembuatan multi-persona dengan instruksi sistem yang unik, serta kemampuan penyuntingan prompt secara dinamis. Anda mendapatkan pengalaman navigasi visual sekelas platform komersial papan atas, namun dengan seluruh mesin pemrosesan yang berputar di bawah meja Anda sendiri.
Menautkan Basis Pengetahuan Pribadi Menggunakan Retrieval Augmented Generation
Salah satu manfaat terbesar saat menjalankan AI lokal adalah kemampuan membaca tumpukan berkas dokumen pribadi tanpa rasa waswas akan spionase data. Melalui integrasi Retrieval-Augmented Generation atau RAG, Anda dapat menautkan puluhan dokumen PDF berupa catatan keuangan, manual operasional standar, atau arsip penelitian pribadi ke dalam sistem pengindeksan vektor lokal. Ketika Anda mengajukan pertanyaan spesifik, model akan menggali jawaban akurat berdasar rujukan berkas internal Anda tanpa mengarang informasi palsu.
Menutup Akses Jaringan Luar demi Menjaga Isolasi Lingkungan Kerja
Untuk mengunci keamanan secara mutlak, pastikan pelayan aplikasi inferensi Anda dikonfigurasi agar hanya merespons permintaan dari alamat internal localhost 127.0.0.1. Hindari membuka port jaringan tersebut ke jaringan internet publik melalui konfigurasi router rumah. Dengan mengisolasi alur komunikasi data hanya di dalam memori komputer, bahkan ancaman peretasan jaringan nirkabel lokal sekali pun tidak akan mampu menyadap interaksi teks rahasia yang tengah Anda diskusikan bersama asisten digital Anda.
Menguji Performa Latensi Token per Detik Secara Berkala
Tolok ukur efektivitas lingkungan kerja mandiri tecermin pada metrik kecepatan keluaran teks atau token per second. Manusia umumnya membaca teks pada rentang kecepatan 5 hingga 8 kata per detik. Apabila konfigurasi perangkat keras Anda sanggup menghasilkan keluaran stabil di angka 15 hingga 25 token per detik, alur kerja interaktif dipastikan berjalan sangat mulus. Evaluasi performa ini secara rutin setelah melakukan pembaruan sistem operasi guna mendeteksi apakah terjadi degradasi alokasi daya pada kartu grafis Anda.
Menimbang Biaya Investasi Perangkat Dibandingkan Langganan Bulanan
Banyak kalangan merasa ragu beralih ke komputasi mandiri karena terpaku pada harga awal komponen perangkat keras kelas atas. Kendati demikian, kalkulasi finansial jangka panjang sering kali menunjukkan narasi yang berkebalikan.
Analisis Efisiensi Biaya Operasional Jangka Panjang
Biaya langganan satu akun layanan kecerdasan buatan komersial rata-rata memakan biaya 20 hingga 30 dolar Amerika Serikat setiap bulan. Dalam kurun waktu dua tahun, pengeluaran untuk satu orang pengguna saja sudah melampaui angka delapan juta rupiah, belum termasuk potensi lonjakan biaya saat kuota token ditingkatkan. Bagi sebuah studio kreatif atau kantor hukum beranggotakan lima orang, biaya tahunan tersebut membengkak drastis. Biaya investasi awal untuk menjalankan AI lokal memang terasa signifikan di awal pengadaan, namun mesin komputasi tersebut berstatus sebagai aset fisik berwujud yang memiliki nilai depresiasi wajar dan dapat dimanfaatkan untuk beragam keperluan komputasi berat lainnya.
Kapan Waktu Paling Tepat Mempertahankan Layanan Komputasi Berbayar
Sikap bijak dalam memandang teknologi menuntut objektivitas tanpa fanatisme berlebih. Layanan awan komersial tetap memiliki posisi strategis ketika Anda membutuhkan model penalaran raksasa berukuran ratusan miliar parameter untuk analisis saintifik murni yang melampaui daya tampung perangkat keras meja kerja. Strategi terbaik bagi profesional modern adalah menerapkan arsitektur hibrida. Seluruh dokumen rahasia, data klien, dan analisis internal dikelola secara ketat melalui mesin luring, sedangkan tugas kompilasi informasi publik tanpa risiko privasi dapat sesekali dialihkan ke layanan eksternal jika situasi mendesak.
Menatap Masa Depan Kemandirian Teknologi Digital Tanpa Ketergantungan
Percepatan inovasi algoritma kompresi dan arsitektur model terbuka membuktikan bahwa kecerdasan komputasi tidak lagi dimonopoli oleh segelintir korporasi raksasa Silicon Valley. Model-model berukuran kompak kini mampu mengimbangi penalaran model awan yang jauh lebih rakus daya. Mengambil langkah untuk memegang kendali atas perangkat pemrosesan data bukan lagi sekadar hobi teknis kaum antusias komputer, melainkan bentuk kesadaran perlindungan aset intelektual di tengah lanskap digital yang kian rentan intervensi.
Sejalan dengan komitmen redaksi PutihBersih dalam menyajikan panduan teknologi yang mencerahkan, bertanggung jawab, dan mengedepankan kedaulatan pengguna, transformasi menuju sistem mandiri merupakan langkah antisipatif paling rasional. Penguasaan atas alat kerja digital mengembalikan kendali produktivitas sepenuhnya ke tangan Anda sendiri tanpa dibayangi ancaman pemblokiran akun, kenaikan tarif mendadak, maupun kebocoran privasi rahasia.
Pada akhirnya, langkah berani untuk menjalankan AI lokal membuktikan bahwa privasi sejati dan efisiensi kerja berteknologi tinggi dapat diraih secara harmonis tanpa kompromi. Dengan menyiapkan spesifikasi perangkat yang tepat, mengonfigurasi perangkat lunak inferensi secara terukur, serta membatasi akses lalu lintas jaringan secara disiplin, Anda berhasil membangun benteng kedaulatan digital yang kokoh bagi masa depan karier profesional Anda.