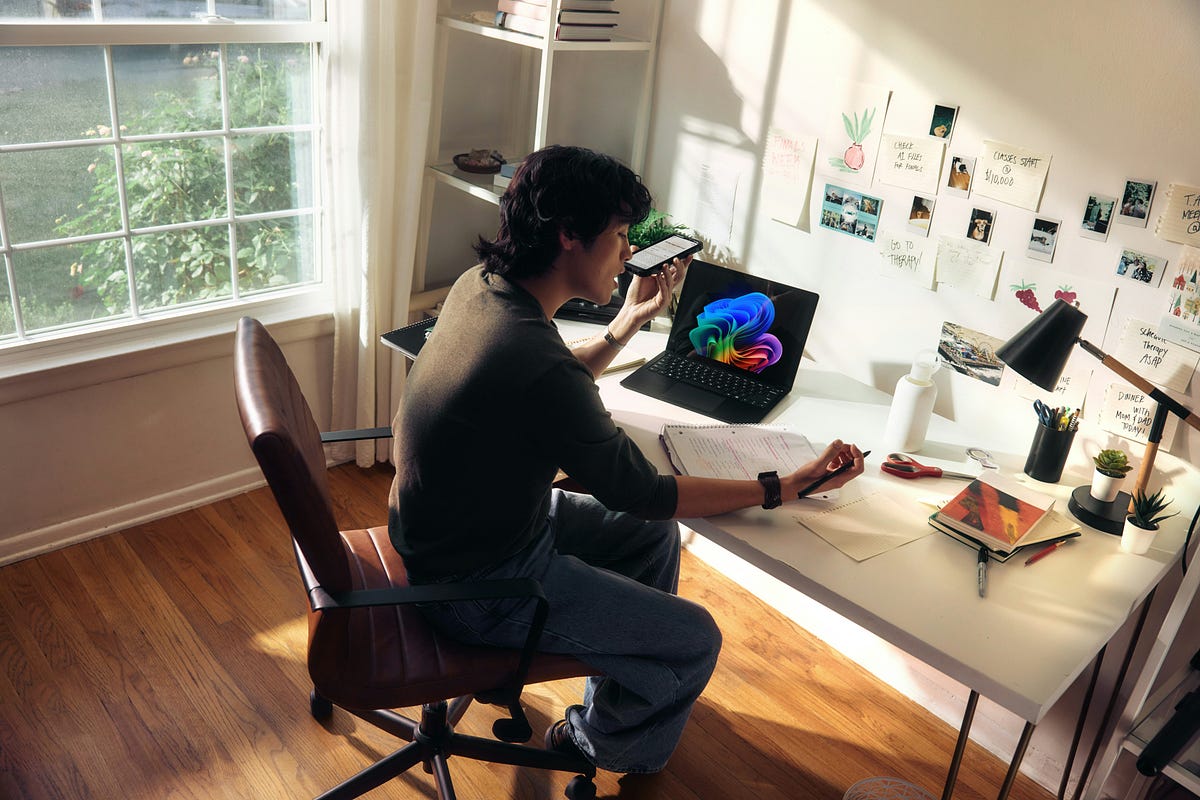
Keputusan mengeksekusi AI lokal di laptop kini bukan lagi sekadar eksperimen para penggiat komputer antusias, melainkan benteng pertahanan utama privasi digital. Ketika layanan kecerdasan buatan berbasis awan terus menyedot miliaran percakapan pengguna untuk melatih model generasi berikutnya, kekhawatiran atas kebocoran rahasia dagang, draf paten, dan data finansial kian memuncak. Setiap baris teks, susunan kode pemrograman, maupun berkas dokumen yang dikirimkan ke peladen publik berpotensi tersimpan di pangkalan data terpusat yang rentan terhadap peretasan atau perubahan regulasi sepihak dari korporasi penyedia layanan.
Menjalankan model bahasa besar secara mandiri di atas perangkat keras pribadi membalikkan relasi kuasa tersebut. Seluruh komputasi berlangsung di ruang isolasi memori Anda sendiri, tanpa sebutir pun paket data yang meluncur melintasi jaringan internet. Pendekatan ini bukan hanya mengembalikan kedaulatan data ke tangan pengguna seutuhnya, melainkan juga menghadirkan kebebasan berkarya tanpa sensor algoritmik berlebihan atau tagihan langganan bulanan yang mencekik arus kas profesional independen.
Alasan Krusial Beralih dari Cloud Menuju Pemrosesan Mandiri
Ketergantungan kronis terhadap raksasa teknologi penyedia komputasi awan sering kali membutakan pengguna dari risiko laten yang mengintai di balik kemudahan antarmuka peramban. Di balik kecepatan respons server terpusat, ada pertukaran tak seimbang antara kepraktisan sesaat dan kendali mutlak atas kerahasiaan informasi berharga.
Menjamin Keamanan Dokumen Rahasia Perusahaan
Dalam lanskap korporasi modern, kebocoran data internal kerap terjadi bukan lewat aksi peretasan canggih dari peretas luar, melainkan keteledoran staf yang menempelkan draf strategi bisnis ke platform daring tanpa enkripsi memadai. Lembaga resmi pengawas siber seperti Badan Siber dan Sandi Negara berulang kali mengingatkan pentingnya mitigasi risiko kebocoran data melalui pembatasan akses data primer ke peladen pihak ketiga di luar yurisdiksi nasional. Saat ini banyak profesional menyadari bahwa memproses AI lokal di laptop menghindarkan rekaman prompt sensitif dari penambangan data pihak ketiga. Apa pun yang diketikkan, mulai dari analisis neraca keuangan hingga rancangan kode sumber perangkat lunak, musnah dari memori begitu aplikasi ditutup tanpa meninggalkan jejak forensik di peladen asing.
Menghilangkan Ketergantungan Terhadap Sambungan Internet Stabil
Pernahkah Anda terjebak tenggat waktu krusial di dalam kabin pesawat, ruang bawah tanah kantor, atau area pelosok tanpa sinyal seluler yang memadai? Layanan komputasi awan langsung lumpuh seketika koneksi terputus. Sebaliknya, kecerdasan buatan yang tertanam di media penyimpanan lokal tetap beroperasi dengan kecepatan penuh tanpa memedulikan status jaringan. Model bahasa mandiri mentransformasikan laptop portabel menjadi stasiun kerja mandiri yang mampu menyusun laporan analitis, menerjemahkan dokumen tebal, atau membedah logika rumit di mana pun Anda berada tanpa kendala kuota.
Fondasi Perangkat Keras yang Wajib Dipersiapkan
Kendati perkembangan teknik kompresi model telah melonjak sangat pesat, mengeksekusi miliaran parameter matematika tetap menuntut pasokan daya komputasi yang realistis. Memahami batasan dan potensi silikon laptop Anda merupakan langkah awal agar proses instalasi tidak berakhir dengan sistem operasi yang macet total akibat kehabisan sumber daya.
Peran Vital Kapasitas Memori RAM dan Unified Memory
Memori akses acak atau RAM adalah panggung utama tempat seluruh bobot model kecerdasan buatan diletakkan saat bertugas. Untuk menjalankan model berukuran 7 miliar hingga 8 miliar parameter secara nyaman, laptop Windows membutuhkan RAM minimal 16 gigabita, sementara kapasitas 32 gigabita memberikan ruang napas yang sangat lega untuk membuka banyak aplikasi kerja sekaligus. Pada ekosistem Apple Silicon seperti lini chip M1 hingga M4, arsitektur Unified Memory menawarkan lompatan efisiensi luar biasa. Karena CPU dan GPU berbagi kolam memori berkecepatan tinggi yang sama tanpa hambatan transfer lintas bus konvensional, MacBook dengan RAM 16 atau 24 gigabita mampu melibas model bahasa besar dengan kecepatan inferensi yang sangat mengesankan.
Kebutuhan Kartu Grafis dan Akselerasi Prosesor AI
Pada ekosistem PC Windows, kehadiran kartu grafis diskret dengan memori grafis VRAM khusus menjadi penentu utama kelancaran interaksi percakapan. Kartu grafis modern yang dibekali VRAM 8 gigabita ke atas memungkinkan pemindahan seluruh lapisan komputasi model ke inti pemrosesan paralel GPU, menghasilkan keluaran teks puluhan token per detik. Namun, bagi pemilik laptop tipis tanpa kartu grafis mandiri, kehadiran prosesor modern yang mengintegrasikan Neural Processing Unit atau NPU serta instruksi vektor CPU mutakhir kini sanggup menjalankan inferensi dasar secara efisien. Perlu dipahami bahwa sebelum mulai mengunduh model, spesifikasi perangkat keras menentukan apakah eksekusi AI lokal di laptop akan berlangsung mulus atau justru membuat mesin kepanasan.
Langkah Praktis Menjalankan Model Cerdas Tanpa Jalur Awan
Komunitas sumber terbuka dunia telah berhasil mengubah ekosistem komputasi kecerdasan buatan dari yang mulanya sarat konfigurasi pustaka Python rumit menjadi perangkat lunak siap pakai yang dapat dioperasikan oleh siapa saja hanya dalam hitungan menit.
Pemanfaatan Ollama untuk Eksekusi Cepat Berbasis Terminal
Bagi pengguna yang menyukai kesederhanaan dan efisiensi konsumsi memori, Ollama berdiri sebagai standar emas perkakas modern. Aplikasi ini membungkus infrastruktur komputasi mesin inferensi ke dalam satu berkas biner ringan yang berjalan mulus di macOS, Linux, maupun Windows. Cukup dengan mengetikkan perintah singkat di jendela baris perintah, sistem secara otomatis mengunduh bobot model dari repositori terkurasi, mengalokasikan lapisan ke VRAM secara proporsional, dan membuka sesi percakapan interaktif instan. Lebih dari itu, perangkat lunak perantara menjadi jembatan utama yang memungkinkan pengoperasian AI lokal di laptop tanpa perlu keahlian pemrograman tingkat tinggi. Ollama juga menyediakan titik akhir REST API lokal di porta standar mesin Anda, memudahkan integrasi dengan perkakas otomatisasi catatan harian seperti Obsidian atau antarmuka peramban kerja.
Penggunaan LM Studio dengan Tampilan Grafis Intuitif
Apabila Anda lebih terbiasa dengan antarmuka visual percakapan modern yang ramah pengguna, LM Studio merupakan alternatif paling matang saat ini. Perangkat lunak ini menyediakan peramban katalog model bawaan yang terhubung langsung ke basis data Hugging Face, memudahkan pencarian model populer berdasarkan popularitas dan kecocokan memori perangkat keras Anda. Anda cukup menekan tombol unduh, menentukan jumlah lapisan komputasi yang ingin dialihkan ke kartu grafis melalui penggeser visual, dan langsung berdialog di ruang obrolan yang nyaman. Kemudahan antarmuka visual ini sangat ramah bagi siapa saja yang ingin mencicipi AI lokal di laptop dalam hitungan menit tanpa harus bersentuhan dengan baris kode terminal.
Pemilihan Model Kompak Llama 3 dan Mistral yang Tepat
Kualitas jawaban yang Anda peroleh bergantung sepenuhnya pada arsitektur bobot model yang dipilih ke dalam memori. Untuk kebutuhan analisis umum, penulisan esai, dan bantuan penerjemahan, model keluarga Llama 3.1 berukuran 8B parameter atau Mistral 7B Instruct menawarkan rasio paling seimbang antara kecerdasan nalar, kefasihan tata bahasa, dan kecepatan komputasi. Hindari memaksakan diri mengunduh model raksasa berukuran 70B parameter jika perangkat keras Anda hanya memiliki RAM pas-pasan, karena sistem operasi akan terpaksa melakukan teknik alokasi ke media penyimpanan SSD yang jauh lebih lambat sehingga menyebabkan komputer macet seketika.
Strategi Optimasi Performa agar Sistem Tetap Ringan
Mengoperasikan model bahasa lokal pada laptop tipis menuntut strategi penyesuaian parameter yang cermat agar performa komputasi seimbang dengan kestabilan suhu perangkat dan efisiensi baterai.
Penerapan Teknik Kuantisasi Bobot Model
Kuantisasi adalah inovasi matematika krusial di balik demokratisasi kecerdasan buatan personal. Format berkas GGUF memungkinkan bobot model asli yang mulanya berpresisi 16-bit ditekan menjadi representasi 4-bit atau 5-bit tanpa penurunan kualitas pemikiran yang terasa oleh pengguna awam. Varian kuantisasi Q4_K_M dan Q5_K_M merupakan pilihan paling rasional bagi pengguna laptop, karena berhasil memangkas kebutuhan memori hingga separuh lebih kecil dari ukuran aslinya. Melalui teknik pemangkasan presisi matematika, konfigurasi AI lokal di laptop dapat menghasilkan respons kilat tanpa mengorbankan logika berpikir model saat memproses dokumen yang panjang.
Manajemen Alokasi Konteks Memori Jendela Percakapan
Konteks jendela menentukan seberapa banyak halaman teks interaksi lampau atau dokumen acuan yang dapat diingat oleh model dalam satu sesi diskusi. Menyetel jendela konteks hingga batas ekstrem seperti 32.000 atau 128.000 token secara serampangan akan melahap RAM dalam jumlah sangat masif untuk menampung KV Cache, bahkan sebelum model sempat mengeluarkan satu kata pun. Untuk kebutuhan penulisan harian dan analisis draf kerja standar, membatasi panjang konteks di angka 4.096 hingga 8.192 token sudah lebih dari cukup untuk menjaga respons mesin tetap gesit dan temperatur kipas pendingin tetap hening.
Langkah Pengamanan Tambahan dalam Ekosistem Komputasi Mandiri
Kendati pemrosesan inferensi berlangsung sepenuhnya di dalam perangkat tanpa melewati jaringan eksternal, integritas keamanan sistem operasi tuan rumah tetap menjadi garis depan yang tidak boleh diabaikan. Pastikan seluruh model yang Anda unduh berasal dari pembuat terverifikasi di repositori terpercaya guna mencegah serangan injeksi kode berbahaya lewat berkas tensor yang telah dimanipulasi pihak tidak bertanggung jawab.
Selain itu, periksa konfigurasi jaringan lokal agar porta API perangkat lunak inferensi Anda terkunci secara ketat pada alamat localhost lokal (127.0.0.1) dan tidak terbuka ke jaringan nirkabel publik saat Anda bekerja di ruang publik atau kedai kopi. Sikap cermat semacam ini memastikan bahwa laptop Anda tidak dapat diakses secara tidak sah oleh perangkat lain yang berada dalam satu jaringan nirkabel yang sama.
Sebagai media rujukan yang menjunjung tinggi etika penelusuran digital, kami menyajikan telaah ini berlandaskan kebijakan perlindungan pembaca yang menempatkan independensi serta keamanan pengguna sebagai prioritas utama. Menguasai teknologi kecerdasan buatan tidak selamanya harus dibayar mahal dengan menyerahkan kedaulatan informasi berharga kepada konglomerasi teknologi global. Pada akhirnya, membangun kebiasaan menjalankan AI lokal di laptop memberikan otonomi penuh atas kedaulatan informasi berharga kita, merawat privasi tanpa sedikit pun mengorbankan potensi produktivitas di masa depan.